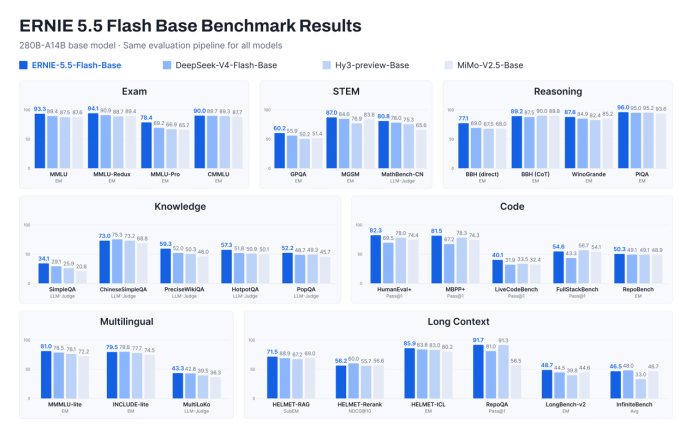
Baidu, 5 Kasım'da en yeni temel modeli Ernie 5.5 Flash Base'i (文心5.5 Flash Base) açık kaynak olarak yayımladı. Model, karma uzman (MoE) mimarisiyle geliştirildi; toplam 280 milyar parametreye sahip olup her token için 14 milyar parametre etkinleşiyor. Model, 33,5 trilyon token ile önceden eğitildi. Ön eğitimde bağlam uzunluğu 128K'ya kadar çıkarken, ince ayar ve çıkarım aşamalarında 1 milyon token'a kadar bağlam destekleniyor.
Kaynağa göre model, bilgi, akıl yürütme, matematik, kod, çok dilli ve uzun bağlam gibi birçok ölçütte aynı boyuttaki modeller arasında en iyi sonuçları aldı. Model, DeepSeek-V4-Flash-Base, Hy3-preview-Base ve MiMo-V2.5-Base gibi modelleri geride bıraktı. Modelin açık kaynak adresi huggingface.co/baidu/ERNIE-5.5-Flash-Base olarak paylaşıldı.
Kaynağa göre model, uzun belgeler, çok turlu etkileşimler ve yapay zeka ajanı görevleri nedeniyle artan bilgi yükünün hesaplama ve bellek maliyetini yükseltmesi üzerine verimlilik odağıyla tasarlandı. Mimaride Latent-Gated Sparse Attention yapısı kullanılıyor; bu yapı seyrek dikkat, düşük ranklı kapılı dikkat ve sanal baş dikkatini birleştiriyor. Düşük ranklı kapılı dikkat, kapı projeksiyon ağırlıklarının parametre sayısını yüzde 75 azaltıyor. Multi-Router Latent MoE ise birden fazla bağımsız yönlendiricinin uzman seçiminde birlikte çalışmasını sağlıyor ve etkin uzman sayısını, hesaplama miktarını ve iletişim miktarını değiştirmeden tutuyor.
ECHO adlı eğitim hedefi, ayrı bir MTP modülü eklemeden modelin son katmanını yeniden kullanarak sonraki token'ları tahmin etmesini sağlıyor. Bu katman, spekülatif kod çözme için taslak model olarak da kullanılabiliyor. Ayrıca Baidu, dağıtık Muon optimizasyonunu iyileştirdi ve büyük head dim için FlashMask-4 dikkat operatörünü tanıttı. Kaynağa göre Base modeller, geliştiricilere ve kurumlara kendi ihtiyaçlarına göre ince ayar ve özelleştirme alanı sunuyor.